OSS監視ツールから商用ツールへの移行を決めたあと、詰まるのは「何から手をつけるか」と「移行後に本当に楽になるのか」の2点です。現状棚卸から安定化までの6段階を、各段階のタスク・担当・成果物と、進むか止まるかの判断基準まで具体的に示します。
Part 1:移行プロジェクトの進め方
1. 移行プロジェクトの6フェーズ
OSSネットワーク監視ツールからの移行は、以下の6つのフェーズで段階的に進めることを推奨します。
各フェーズの目的と想定期間を把握した上で、全体スケジュールを策定してください。
| # | フェーズ | 想定期間 | 目的・ゴール |
|---|---|---|---|
| 1 | 現状棚卸 | 2〜4週間 | 現行の監視構成(対象機器、監視項目、閾値、アラート通知先、スクリプト、ジョブ)を網羅的に棚卸し、移行要件の基盤とする。 |
| 2 | 要件定義 | 2〜3週間 | 棚卸結果をもとに、新環境で実現すべき監視要件・運用要件を定義。「現状の再現」と「改善したい点」を明確に分離する。 |
| 3 | PoC(検証) | 2〜4週間 | 本番環境の一部(代表的なサブネットや機器群)を対象に新ツールを導入し、要件定義で定めた監視項目・アラート・レポートが実現できるかを検証する。 |
| 4 | 並行運用 | 2〜4週間 | 新旧ツールを並行稼働させ、アラートの一致率・検知精度・レスポンス速度を比較。運用チーム全員が新ツールの操作に習熟する期間でもある。 |
| 5 | 切替 (カットオーバー) | 1〜2週間 | 旧ツールの監視を停止し、新ツールに完全移行。通知先・エスカレーション経路・ダッシュボードの最終確認と社内周知を実施。 |
| 6 | 安定化 | 4〜8週間 | 切替後の監視環境を安定運用に移行。閾値の微調整、不要アラートの削減、レポートの最適化、運用手順書の最終版策定を行う。 |
全体の想定期間は約3〜6か月です。規模や要件の複雑さに応じて調整してください。特にフェーズ1(現状棚卸)の精度が以降のフェーズの品質を左右するため、十分な時間を確保することが重要です。
2. フェーズ別タスク一覧
各フェーズで実施すべき具体的なタスクと、担当者の役割分担を以下に整理します。
社内の移行プロジェクト計画書に転記できる粒度で記載しています。
フェーズ1:現状棚卸
| タスク | 担当 | 成果物 |
|---|---|---|
| 監視対象機器・サーバーの一覧作成(IP、ホスト名、機種、OS、用途) | インフラチーム | 監視対象台帳 |
| 監視項目・閾値の棚卸(SNMP OID、カスタムスクリプト含む) | インフラチーム | 監視項目一覧 |
| アラート通知先・エスカレーション経路の整理 | インフラチーム | 通知フロー図 |
| カスタムスクリプト・cronジョブの洗い出しと用途の記録 | インフラチーム | スクリプト台帳 |
| レポート・ダッシュボード要件の整理 | インフラチーム+管理層 | レポート要件書 |
フェーズ2:要件定義
| タスク | 担当 | 成果物 |
|---|---|---|
| 「現状再現」要件と「改善」要件の分類・優先順位付け | インフラチーム | 要件定義書 |
| 新ツールの機能とのギャップ分析 | インフラチーム+ベンダー | ギャップ分析表 |
| 移行対象外とするスクリプト・監視項目の判定 | インフラチーム | 除外リスト |
| PoC対象範囲(サブネット・機器群)の選定 | インフラチーム+ベンダー | PoC計画書 |
フェーズ3:PoC(検証)
| タスク | 担当 | 成果物 |
|---|---|---|
| PoC環境の構築・自動ディスカバリーの実行 | ベンダー+インフラチーム | PoC環境 |
| 主要監視項目・アラートの動作確認 | インフラチーム | 検証結果報告書 |
| カスタムMIBの登録・動作確認(該当する場合) | インフラチーム | MIB登録リスト |
| レポート・ダッシュボードの再現性確認 | インフラチーム | レポートサンプル |
| PoC評価チェックリストに基づくGo/No-Go判定 | インフラチーム+管理層 | Go/No-Go判定書 |
フェーズ4〜6:並行運用・切替・安定化
| タスク | 担当 | フェーズ |
|---|---|---|
| 新旧ツールの並行稼働とアラート一致率の比較 | インフラチーム | 4:並行運用 |
| 運用チーム全員のハンズオントレーニング | ベンダー+インフラチーム | 4:並行運用 |
| 旧ツールの監視停止・新ツールへの完全切替 | インフラチーム | 5:切替 |
| 通知先・エスカレーション経路の最終切替と社内周知 | インフラチーム+管理層 | 5:切替 |
| 閾値の微調整・ノイズアラートの削減 | インフラチーム | 6:安定化 |
| 運用手順書の最終版策定・ナレッジベース化 | インフラチーム+管理層 | 6:安定化 |
3. よくある落とし穴——移行プロジェクトで見落としがちなポイント
監視ツールの移行プロジェクトでは、技術的な移行作業だけに集中してしまい、以下のような重要なポイントが見落とされがちです。
落とし穴1:監視構成の棚卸が不完全
OSS監視ツールの運用が属人化している場合、監視設定の全容を正確に把握している人がいない可能性があります。特に長期間運用されてきた環境では、もう使われていないスクリプトや、理由が不明な閾値変更が残っていることがあります。フェーズ1で「知っていること」だけでなく「知らないこと」も洗い出す意識が重要です。
落とし穴2:アラート閾値の「再設計」を忘れる
既存のアラート閾値をそのまま新ツールに移行するだけでは、ツール変更の効果を十分に発揮できません。長年の運用で蓄積された「とりあえず設定した閾値」や「過去の障害後に場当たり的に変更した閾値」は、この機会に設計意図から見直すべきです。商用ツールのベンダー提供テンプレートに含まれる標準閾値をベースラインとして活用し、自社の要件に合わせて調整するアプローチが効率的です。
落とし穴3:SNMP MIBの移行漏れ
OSS監視ツールでベンダー固有のMIBを使用してカスタム監視を行っている場合、それらのMIBファイルとOIDマッピングを新ツールに移行する必要があります。標準MIB(IF-MIB、Host Resources MIB等)は商用ツールに組み込み済みですが、カスタムMIBは個別に登録が必要です。フェーズ1で使用中のMIBの棚卸を忘れずに実施してください。
落とし穴4:通知チャネルの移行
メール通知、Slack/Teams連携、SMS通知、外部チケットシステム連携(ServiceNow、PagerDuty等)の設定は、監視ツール本体の移行とは別に設定・検証が必要です。特にWebhookやAPI連携を使用している場合は、フェーズ3(PoC)で動作確認を完了させておくことを推奨します。
4. 製品機能マッピング——移行フェーズごとの
OpManager / Site24x7対応機能
各移行フェーズで活用できるOpManager / Site24x7の機能を以下にマッピングします。
| フェーズ | OpManager の対応機能 | Site24x7 の対応機能 |
|---|---|---|
| 1:現状棚卸 | マルチプロトコル自動ディスカバリー(SNMP/WMI/ICMP/CLI)。IPレンジスキャンまたはシードデバイスベースで監視対象を自動検出。デバイスタイプを自動分類し、11,000+テンプレートライブラリから適合するテンプレートを自動適用。ディスカバリールールエンジン(サブネット、デバイスタイプ、SNMPコミュニティ文字列でフィルタリング)。 | 軽量エージェント(Windows/Linux)によるサーバー検出。オンプレミスポーラーによるSNMP/WMI機器の検出。クラウドリソース(AWS/Azure/GCP/OCI)はプロバイダーAPI経由でエージェントレスに自動検出。 |
| 3:PoC | 11,000+テンプレートに含まれるデフォルト閾値・アラートルールをベースラインとして即座に適用可能。依存関係を考慮したアラート(アラートストーム抑制)により、PoCでも精度の高い検証が可能。MIBブラウザー(設定→ツール→MIBブラウザー)でカスタムMIBを.mib/.txt/.my/.mi2形式でアップロード。SNMP v1/v2c/v3対応。 | 7言語対応のAPMエージェント(Java, .NET, PHP, Ruby, Node.js, Python, Go)。200以上のクラウドサービス監視プラグインが即時利用可能。AI(Zia)によるアノマリ検知のPoC検証。 |
| 4:並行運用 | カスタムダッシュボードビルダーで新旧比較ビューを構築。アラートはメール、SMS、Webhook(Slack/Teams)、サードパーティ連携(PagerDuty、ServiceNow、ServiceDesk Plus)に対応。マルチレベルエスカレーション。 | 統合ダッシュボードで複数環境を一画面に集約。リアルユーザーモニタリング(RUM)とシンセティックモニタリングの並行検証。 |
| 5-6: 切替・安定化 | SNMPトラップ / Syslog処理でイベント集約。コードフリーのワークフロー自動化で一次対応を自動化。Network Configuration Manager、NetFlow Analyzer、Firewall Analyzer、IPアドレス管理とのネイティブ統合による運用範囲の拡大。 | ログ管理との統合でインシデント調査を効率化。マルチクラウド統合ダッシュボードで運用の可視化を完成。 |
5. PoC移行判断チェックリスト——Go / No-Go判定のための評価基準
フェーズ3(PoC)の完了後、本番移行に進むかどうかを判断するための評価チェックリストです。すべての項目を満たす必要はありませんが、「必須」と記載された項目は本番移行の前提条件として位置づけてください。
-
現行の監視対象機器がすべて自動ディスカバリーで検出されたか
必須 -
主要な監視項目(CPU、メモリ、インターフェース、応答時間)が正しく取得できているか
必須 -
カスタムMIBの登録・OIDの取得が正常に動作しているか
必須(該当時) -
アラート閾値が要件定義の基準を満たし、適切に発報されるか
必須 -
アラート通知(メール、Slack/Teams、SMS等)が正しく配信されるか
必須 -
依存関係アラート(アラートストーム抑制)が期待どおりに動作するか
推奨 -
ダッシュボード・レポートが要件を満たす形式で出力されるか
推奨 -
運用チームのメンバーがGUIで基本操作(監視追加・閾値変更・アラート確認)を実行できるか
必須 -
PoC対象範囲でのパフォーマンス(ポーリング間隔、画面レスポンス)が許容範囲か
必須 -
既存のスクリプト・自動化処理に対する代替手段が確認されているか
推奨 -
ライセンス費用が予算枠に収まることが確認されているか
必須 -
ベンダーの日本語技術サポートの対応品質が確認されているか
推奨
本番移行に進行可能。
Part 2: 移行後の統合運用——監視・コンフィグ管理・インシデント対応の一元化
6. なぜ統合運用が重要なのか
監視ツールの移行が完了した後、次に直面する課題は「監視だけでは障害対応が完結しない」という現実です。障害を検知しても、その原因を特定し、対処するためには、ネットワーク機器のコンフィグ情報や設定変更の履歴にアクセスする必要があります。
多くの運用現場では、監視ツール、コンフィグ管理ツール、インシデント管理ツールがそれぞれ独立しており、障害対応のたびに複数の画面を行き来しながら情報を突き合わせる作業が発生します。このツール間のサイロは、MTTR(平均修復時間)を押し上げる主要因の一つです。
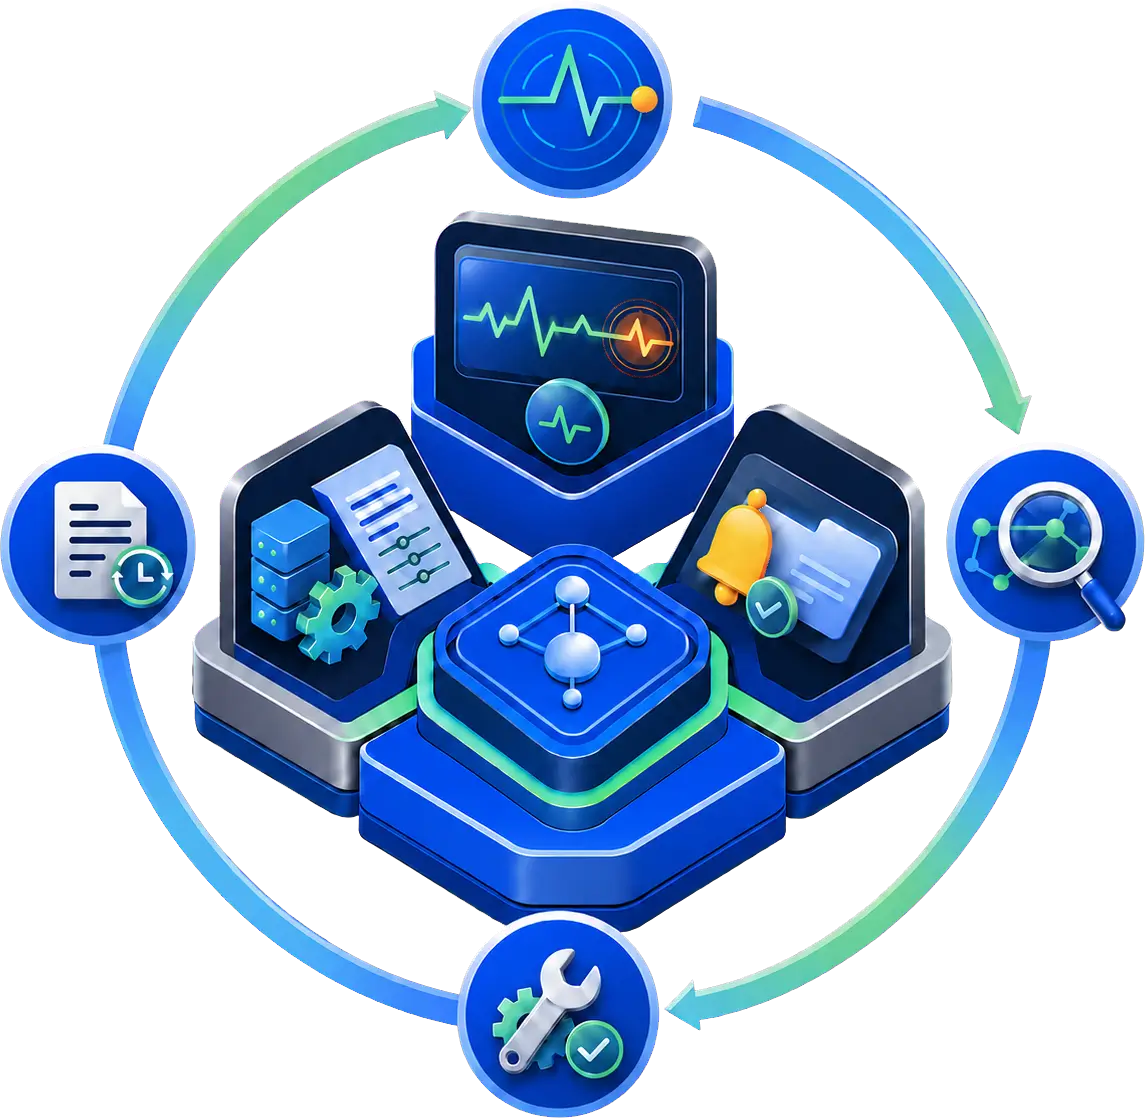
統合運用とは、監視(Monitoring)、コンフィグ管理(Configuration Management)、インシデント対応(Incident Response)を一つのプラットフォーム上で連携させ、障害の「検知→原因特定→対処→記録」までを一貫したワークフローで実行できる状態を指します。
7. OpManager Plusで実現する統合運用フロー
OpManager Plusは、ネットワーク監視とネットワークコンフィグ管理機能を含んでおり、追加のライセンス購入は不要です。以下に、障害発生から復旧までの統合運用フローを示します。
OpManager Plusがネットワーク機器のパフォーマンス低下、デバイスダウン、コンフィグ変更によるアノマリーを検知し、アラートを発報します。アラートはダッシュボードに即座に表示されるとともに、設定済みの通知チャネル(メール、Slack/Teams、SMS等)に配信されます。
コンフィグ管理機能により、アラート発生前後のネットワーク機器のコンフィグ変更履歴を即座に確認できます。「いつ」「誰が」「何を」変更したかのタイムラインが表示されるため、コンフィグ変更が障害の原因であるかどうかを迅速に判断できます。
コンフィグ変更が障害原因と判明した場合、保存されている変更前のコンフィグにロールバックする操作を実行できます。また、ハードウェア障害による機器交換が必要な場合は、最新のコンフィグ情報を交換後のデバイスにプッシュ配信し、通信の復旧を迅速に行えます。
障害の検知から原因特定、対処までの一連のプロセスは、自動的に監査ログとして記録されます。「いつアラートが発報され」「どのコンフィグ変更が原因と特定され」「どのロールバック操作が実行されたか」のタイムラインが残るため、事後のインシデントレビューや監査対応に活用できます。
8. 具体的な障害シナリオでの運用例
シナリオ1:VLAN設定変更に起因するネットワーク障害
| ステップ | 統合運用での対応 |
|---|---|
| 1. 検知 | 特定VLANに所属する複数デバイスの通信断を検知。依存関係アラートにより、コアスイッチのコンフィグ変更が根本原因の可能性としてハイライト。 |
| 2. 原因特定 | コンフィグ変更履歴を確認。アラート発生の30分前にコアスイッチのVLAN設定が変更されていたことを特定。差分表示で変更内容を確認。 |
| 3. 対処 | 変更前のコンフィグにロールバック操作を実行。VLAN設定が変更前の状態に復元され、通信が復旧。 |
| 4. 記録 | 一連の検知→原因特定→ロールバック→復旧確認のタイムラインが監査ログに自動記録。インシデントレビューの際に参照可能。 |
シナリオ2:ハードウェア障害による機器交換
| ステップ | 統合運用での対応 |
|---|---|
| 1. 検知 | スイッチのデバイスダウンを検知。ハードウェア障害と判断し、機器交換を決定。 |
| 2. 原因特定 | 障害機器の最新のコンフィグを取得。 |
| 3. 対処 | 交換後の新デバイスに、コンフィグ情報をプッシュ配信。手動でのコンフィグ投入作業が不要になり、復旧時間を大幅に短縮。 |
| 4. 記録 | 交換後デバイスの監視が自動再開されたことを確認。通信復旧をダッシュボードで確認。 |
9. OSS監視ツールでは難しい統合運用の理由
OSS監視ツールは、監視機能には優れているものの、コンフィグ管理やインシデント対応との連携は標準では提供していません。コンフィグ管理を実現するにはOSSのコンフィグ管理ツールを別途導入・運用する必要があり、監視ツールとの連携にはカスタムスクリプトや手動での情報突き合わせが必要になります。
この構造には以下のような運用上の課題があります。
- 監視アラートとコンフィグ変更の時刻を手動で突き合わせる必要があり、原因特定に時間がかかる
- コンフィグのロールバックも手動操作となり、ヒューマンエラーのリスクが伴う
- 監視ツールとコンフィグ管理ツールでアクセス権限が分離しており、統合的な監査ログが残らない
- ツール間の連携保守(スクリプトの更新、API変更への追随)自体が新たな属人化要因になる
OSS監視ツールからの移行を機に、監視単体ではなく「統合運用」の視点でツールを選定することが、中長期的な運用負荷の軽減につながります。
10. OpManager Plusで実現できる範囲のまとめ
OpManager Plusは、以下の運用領域を単一のプラットフォームで統合的にカバーします。コンフィグ管理機能はOpManager Plusに含まれるため、別途製品を購入する必要はありません。
| 運用領域 | OpManager Plus の対応機能 |
|---|---|
| ネットワーク監視 | SNMP/WMI/ICMP/CLI対応のマルチプロトコル監視、11,000+テンプレート、依存関係アラート、トポロジーマッピング、カスタムダッシュボード |
| コンフィグ管理 | マルチベンダー対応のコンフィグバックアップ・変更検知・差分表示・コンフィグのロールバック・コンプライアンスチェック。コンフィグ変更の「誰が・いつ・何を」の監査証跡。 |
| トラフィック分析 | NetFlow Analyzer統合によるトラフィック可視化・帯域使用状況分析 |
| ファイアウォール管理 | Firewall Analyzer統合によるルール分析・変更管理・コンプライアンスレポート |
| IPアドレス管理 | IPアドレス空間の可視化・サブネット管理 |
| インシデント対応 | コードフリーのワークフロー自動化による一次対応自動化。ServiceDesk Plus / ServiceNow / PagerDuty連携。 |
無料の監視ツールと比較したOpManagerの強みを徹底解説
本記事のカテゴリ比較をさらに掘り下げ、具体的な機能差と導入効果をまとめたホワイトペーパーです。稟議資料の添付資料としてもご活用いただけます。
比較ホワイトペーパーを無料ダウンロード